
صبح اول ماه، اپراتور حقوق و دستمزد یک شرکت وارد سامانه میشود و بهجای گزارش نهایی، پیام خاکستری «خطا در پردازش» میبیند. تیم فنی لاگهای شبکاری را باز میکند: هزاران خط تکراری از یک استثنا (Exception)، بدون شناسه کارمند، بدون نام مرحله پردازش و بدون نشانی اینکه کدام فایل ورودی مقصر بوده است. سرنخ صفر و ساعت از دسترفته، زیاد.
این صحنه حاصل دو اشتباه رایج و متضاد است: یا خطا بلعیده میشود و هیچ ردی نمیماند، یا همهچیز — پیام فنی، جزئیات داخلی، پشته فراخوانی — بیفیلتر بیرون میریزد؛ هم به کاربر و هم به لاگ. در این مقاله علت ریشهای این آشفتگی را میکاویم و راهحل لایهبندیشدهای برای مدیریت خطا (Error Handling) و ثبت رخداد (Logging) میسازیم.
اشتباه رایج: دو افراط در برخورد با خطا
خطایی که بلعیده میشود
الگوی آشنایی است: برنامه بخشی از کد را در بلوک «تلاش کن، اگر خطا شد ادامه بده» میپیچد تا کاربر پیام قرمز نبیند. نتیجه در کوتاهمدت آرامش است و در بلندمدت، فاجعهای بیسرنخ. داده ناقص ثبت میشود، فرایند نیمهکاره پیش میرود و چند هفته بعد کسی میپرسد چرا ماندهحساب بعضی افراد صفر است. خطا که ثبت نشود، در عمل یعنی خطایی که اجازه یافته بیسروصدا تکرار شود.
خطایی که همهچیز را لو میدهد
طرف افراطی دیگر: پشته فراخوانی (Stack Trace) کامل، نسخه فریمورک، مسیر فایلهای سرور و پرسوجوی نافرجام، مستقیم روی صفحه کاربر. این هم تجربه کاربری تلخی دارد و هم نقشه داخلی سیستم را در اختیار کسی میگذارد که شاید دنبال نقطه نفوذ بگردد. و در لاگ هم همان اتفاق با دوز سنگینتر میافتد: هر رخداد چندین خط جزئیات تکراری مینویسد، تا جایی که لاگِ واقعاً مهم میان نویز گم میشود.
علت: دو مخاطب متفاوت با یک پیام
ریشه اشتباه، یکیانگاشتن دو مخاطب کاملاً متفاوت است. کاربر نهایی به این پرسش نیاز دارد: چه شد و حالا چه کنم؟ پاسخش باید کوتاه، خوانا، بیجزئیات فنی و همراه با گام بعدی باشد. توسعهدهنده به پرسش دیگری نیاز دارد: کجا، در چه بستر، با چه دادهای و چرا؟ پاسخش پرجزئیات، دقیق، زماندار و قابل جستوجوست. وقتی یک پیام واحد برای هر دو نوشته میشود، یا برای کاربر بیمعناست یا برای توسعهدهنده فقیر — معمولاً هر دو.
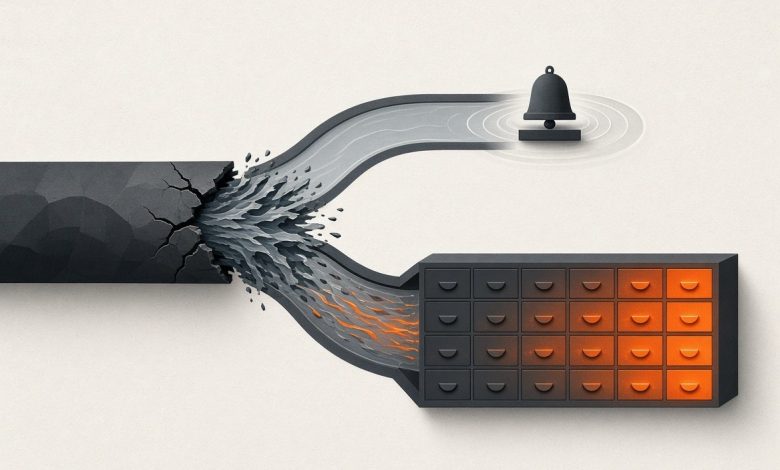
همینجا مرز دو فعالیت مکمل روشن میشود: مدیریت خطا تصمیم میگیرد با خطا چه شود — ادامه، تلاش دوباره، توقف امن — و چه چیزی به کاربر برسد؛ لاگ ثبت میکند در سیستم واقعاً چه گذشت تا کسی که فردا بررسی میکند، صحنه را بازسازی کند. خطا و لاگ همزماناند، اما کارشان یکی نیست.
راهحل: لایهبندی پیام و سطحبندی ثبت
خطای قابل نمایش به کاربر
پیام کاربر سه ویژگی لازم دارد: میگوید چه اتفاقی افتاده (نه چرای فنیاش)، پیشنهاد گام بعدی میدهد — دوباره تلاش کنید، بعداً مراجعه کنید، با پشتیبانی تماس بگیرید — و یک شناسه پیگیری (Correlation ID) نشان میدهد تا اگر کاربر تماس گرفت، پشتیبانی بتواند دقیقاً همان رخداد را در لاگ پیدا کند. با این شناسه، گفتوگوی پشتیبانی از «حالا آنوقت دقیقاً کارتون چی بود؟» به «بگذارید رخداد شماره فلان را ببینم» تبدیل میشود.
سطحهای Log: زبان مشترک اهمیت
همه رخدادها یکجنس نیستند؛ آنها را با سطح (Level) جدا کنید تا هم فیلترکردن ممکن شود و هم هشداردهی معنادار بماند. جدول زیر پرکاربردترین سطحها را خلاصه میکند.
| سطح | چه زمانی استفاده شود؟ | مثال |
|---|---|---|
| Debug | جزئیات دقیق برای بررسی حین توسعه یا رفع ایراد؛ در محیط عملیاتی معمولاً خاموش | مقادیر متغیرهای کلیدی در یک گام محاسبه |
| Info | رخدادهای عادی چرخه عمر که نشان میدهند جریان کار درست پیش میرود | شروع و پایان موفق پردازش فایل حقوق |
| Warning | وضعیت غیرمنتظرهای که هنوز خرابی نیست اما نشانه ناهنجاری است | تلاش دوباره برای فراخوانی سرویس، فایل ورودی با قالب غیرمعمول |
| Error | ناموفقشدن یک عملیات که به توجه و پیگیری نیاز دارد | شکست محاسبه حقوق یک کارمند، با شناسه رخداد |
| Fatal | خرابیای که ادامه کار کل فرایند یا سرویس را ناممکن میکند | قطع دسترسی به پایگاه داده در ابتدای پردازش شبانه |
قاعده حاکم بر این جدول، هزینه توجه انسانی است: هر سطح بالاتر، پررنگتر است و اگر Info با Error مخلوط شود، تیم یا به هشدارها بیتفاوت میشود یا در نویز غرق میشود. هشداردهی باید فقط برای چیزی روشن بماند که «اینجا یک انسان لازم است».
اصول ثبت خطا در عمل
- هر رخداد، یک رکورد معنادار: زمان، سطح، شناسه رخداد، شناسه کاربر یا سفارش مربوط و پیام روشن؛ نه پنج خط پشته برای یک خطای تکراری.
- ثبت بستر (Context): ورودی پردازش، مرحلهای که شکست خورده و شمارنده تلاش؛ جستوجوی لاگ بدون بستر، جستوجو در تاریکی است.
- پرهیز از داده حساس: گذرواژه، رمز یکبارمصرف و شماره کارت کامل به لاگ راه ندارند؛ لاگ خودش یک دارایی است و دسترسی و نگهداریاش باید مثل داده محرمانه مدیریت شود.
- یک بار ثبت، یک بار پرتاب: اگر خطا را در یک لایه لاگ کردید، در لایه بالاتر دوباره لاگش نکنید؛ ثبت چندلایه نویز میسازد، نه سرنخ.
- نوشتن ساختارمند (Structured Logging): هر رکورد با فیلدهای ثابت، تا پرسوجو و پایش خودکار ممکن شود؛ متن آزاد برای انسان خوشایند و برای ابزار بیدردسر نیست.
مثال کاربردی: بازسازی شبکاری سامانه حقوق و دستمزد
همان سامانه را با این اصول بازنویسی کنیم. پردازش شبانه با رخدادهای Info شروع و پایان هر مرحله را ثبت میکند. به فایل ورودی مشکوکی میرسد: ساختار یکی از ردیفها غلط است. اینجا یک Warning ثبت میشود — با نام فایل، شماره ردیف و دلیل — و پردازش طبق سیاست اعلامشده ادامه میدهد اما کارمند مربوط را به فهرست «نیازمند بررسی» میگذارد. وقتی محاسبه حقوق همان کارمند شکست میخورد، رخداد Error با شناسه رخداد و بستر کامل ثبت میشود؛ پردازش بهجای سقوط کامل، کار بقیه را کامل میکند و در پایان با فهرست موارد نیازمند بررسی تمام میشود.
صبح روز بعد، اپراتور بهجای پیام خاکستری، صفحهای میبیند که میگوید پردازش با چند مورد نیازمند بررسی تمام شد و برای هر مورد شناسه پیگیری نشان میدهد. پشتیبانی با همان شناسه در چند ثانیه رکورد لاگ مربوط را پیدا میکند. علت — قالب ردیف فایل ورودی — در چند دقیقه مشخص میشود و اصلاحش یک روز کاری میگیرد؛ نه یک هفته جستوجو در لاگهای بیبستر.
خطا که ثبت نشود، همان خطا فردا هم تکرار میشود؛ اینبار بیسروصدا و بیدلیل.
خطاهای رایج دیگر که تکرار میشوند
- لاگکردن در حلقههای بزرگ با سطح Error برای هر آیتم؛ یک جمعبندی در پایان، دهها برابر خواناتر است.
- استفاده از لاگ بهجای گزارش کسبوکاری؛ لاگ ابزار تشخیص فنی است، نه ثبت رسمی رخداد مالی یا اداری.
- لاگهایی که هرگز خوانده نمیشوند؛ اگر برای هیچ رخدادی واکنشی تعریف نشده، لاگ به انبار خروجیهای بیصاحب بدل میشود.
- چرخش و نگهداری نامرتب فایلها؛ بدون سیاست چرخش لاگ (Log Rotation) و بازه نگهداری، دیسک پر میشود و خودِ لاگ عامل خرابی میگردد.
کاربرد عملی
برای شروع، سه قدم کافی است. نخست، سیاست سطحها را برای تیم بنویسید: چه چیزی Info است و چه چیزی Warning؛ اختلاف نظر بر سر سطحها ریشه اصلی نویز است. دوم، شناسه پیگیری را از مرز ورودی هر درخواست تولید و در همه سرویسهای بعدی حمل کنید تا مسیر یک درخواست در کل سیستم قابل دنبالکردن باشد. سوم، مرور هفتگی رخدادهای Error را به عادت تیم تبدیل کنید؛ الگوها — همان خطای تکراری که هیچکس گزارشش نکرده بود — فقط با مرور منظم دیده میشوند. مدیریت خطای حرفهای نه ابزار گران میخواهد و نه معماری خاص؛ خواست روشن و انضباط کوچک میخواهد.
نکات کلیدی این مقاله
- کاربر و توسعهدهنده دو مخاطباند؛ پیام کاربر کوتاه و گامبعدیمحور و لاگ غنی از بستر است.
- بلعیدن خطا خطرناکتر از نمایش خطاست؛ خطای بیردپا تکرار میشود.
- سطحهای Debug تا Fatal زبان مشترک اهمیتاند؛ بیسطحبندی، هشداردهی بیمعنا میشود.
- شناسه پیگیری روی صفحه، پل میان پشتیبانی و لاگ است و ساعتها جستوجو را حذف میکند.
- داده حساس به لاگ راه ندارد؛ لاگ را مثل دارایی محرمانه مدیریت کنید.
سوالات متداول
اگر برای هر خطا پیام کاربر نداشته باشیم چه؟
برای عملیاتهای پسزمینه و زمانبندیشده که کاربر مستقیمی ندارند، بهجای پیام، مکانیزم اطلاعرسانی داخلی بگذارید: ثبت رخداد با سطح درست و هشدار به کانال تیم. قاعده ساده این است: هر خطای دستنخورده (Unhandled) باید جایی دیده شود؛ «دیده نشدن» تنها حالت غیرقابلقبول است.
حجم بالا و پرتعداد لاگ اشکال دارد؟
عدد جهانی وجود ندارد؛ معیار درست، نسبت سیگنال به نویز است. اگر در بحران بتوانید رخدادهای مهم را بدون غربال دستی پیدا کنید، حجمتان سالم است؛ اگر نه، سطحها را بازبینی کنید. ابزارهای مدیریت لاگ حجم بالا را تحمل میکنند، اما هزینه تمرکز تیم را پس نمیدهند.
تلاش دوباره (Retry) در همه خطاها درست است؟
نه. تلاش دوباره فقط برای خطاهای موقتی معنا دارد — شبکهای یا تأخیر سرویس جانبی. خطای منطقی مثل داده غلط ورودی با تلاش دوباره فقط تکرار میشود. تصمیم «تلاش دوباره یا توقف امن» باید از نوع خطا بیاید، نه از خوشبینی؛ و هر تلاش دوباره با فاصله مشخص، سقف محدود و ثبت در لاگ همراه باشد.