
داشبورد گزارشگیری سازمانی بعد از ماهها کار، بالاخره به محیط عملیاتی رفت. همهچیز در محیط آزمایشی روان بود؛ اما در روزهای نخست استفاده، صفحه فهرست سفارشها که باید در لحظه باز میشد، با هر شرکت بزرگ که وارد میشد سنگینتر میشد. لاگها هیچ خطایی نشان نمیدادند؛ فقط درخواستها آرامتر جواب میگرفتند. مقصر، الگویی معروف به N+1 Query بود که هیچکس عمداً آن را ننوشته بود.
سناریو: صفحه فهرستی که هر سطرش سفر جداگانه میرود
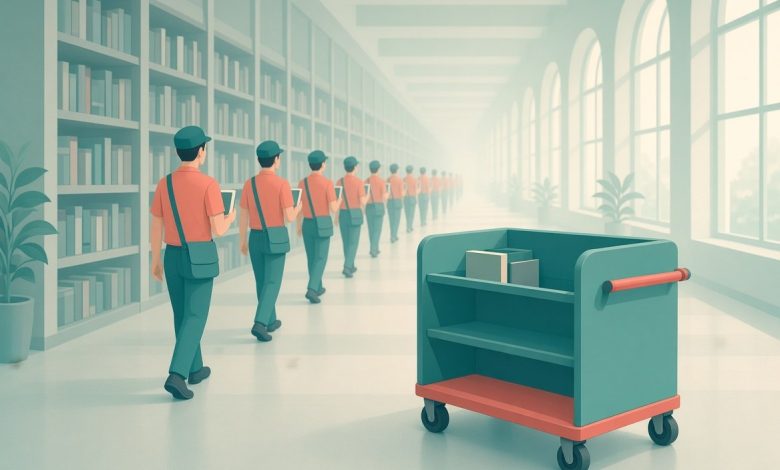
صفحه فهرست سفارشها کاری ساده دارد: آخرین سفارشها را با نام مشتری نشان بدهد. کد سامانه برای گرفتن سفارشها یک پرسوجو میزند و فهرست را میگیرد. اما نام مشتری در همان جدول نیست؛ رابطهای جداگانه است. راهحل سرراستی که در کد پیاده شده، این است که برای هر سطر، نام مشتری را جداگانه بپرسد. نتیجه: یک پرسوجو برای فهرست سفارشها و بهازای هر سفارش، یک پرسوجوی دیگر برای مشتریاش؛ در مجموع چند ده سفر به پایگاه داده فقط برای یک صفحه.
این همان الگوی N+1 است: یک پرسوجوی ریشه، بهعلاوه N پرسوجوی دنبالهدار. بهتنهایی هیچکدام از این سفرها کند نیست؛ مشکل در جمعشان است و در اینکه تعدادشان با تعداد سطرهای فهرست خطی رشد میکند.
تحلیل: چرا این الگو شکل میگیرد و پنهان میماند
نقش بارگذاری تنبل
بسیاری از ابزارهای نگاشت شیء-رابطهای (ORM) برای راحتی توسعهدهنده، بارگذاری تنبل (Lazy Loading) را پیشفرض میگذارند: داده مرتبط فقط وقتی خوانده میشود که کد واقعاً به آن دست بزند. این رفتار در منطق کسبوکار منفرد عالی است؛ اما وقتی همین کد در حلقهای روی فهرست تکرار شود، هر دستزدن به ویژگی مرتبط یک پرسوجوی تازه تولید میکند، بیآنکه در ظاهر کد نشانهای از آن باشد. کد خوانا و تمیز به نظر میرسد؛ پرسوجوها زیرش چند برابر شدهاند.
چرا از چشم آزمونها پنهان میماند
سه عامل پنهانکاری میکند. نخست، داده محیط توسعه کوچک است؛ چند پرسوجوی اضافه روی صد سطر، کسی را نگران نمیکند. دوم، هر پرسوجو جداگانه سریع است و ابزارهای عیبیابی معمولی خطایی ثبت نمیکنند؛ چون چیزی خراب نشده، فقط گران شده است. سوم، هزینه بهصورت جمعی و بهتدریج بالا میآید: همان صفحهای که با حجم کم هنوز قابل تحمل بود، با داده روزهای عملیاتی زمینگیر میشود. N+1 خطای منطقی نیست؛ خطای مقیاس است و فقط در مقیاس دیده میشود.
چرا رفع آن بدون شناسایی ممکن نیست
نکته طنزآمیز ماجرا این است که N+1 در بازبینی کد معمولی سخت دیده میشود، چون قربانیاش معمولاً خطی مختصر و بهظاهر بیضرر است. به همین دلیل رفع، همیشه بعد از شناسایی معنای واقعی دارد: اول باید دید واقعاً چند پرسوجو برای هر درخواست میرود و کدام الگو آنها تولید میکند.
راهکارها: از شناسایی تا رفع
شناسایی قبل از رفع
قدم نخست، دیدن تعداد پرسوجوهاست. فعالکردن گزارش پرسوجو در محیط توسعه و شمردن سطرهای شبیه به هم که پشت سر هم تکرار میشوند، الگو را بیرون میکشد؛ وقتی دهها پرسوجوی یکشکل فقط با یک شناسه متفاوت پشت هم دیده میشوند، تقریباً همیشه N+1 در کار است. در سطح عملیاتی، شمارش تعداد پرسوجوی هر درخواست یک سنجه ساده و گویاست؛ هشداری که وقتی این عدد از حد عادی گذشت روشن شود، بسیاری از موارد را پیش از رسیدن به کاربر میگیرد.
بارگذاری مشتاقانه (Eager Loading)
راهکار مستقیم این است که داده مرتبط همزمان و در همان سفر نخست خوانده شود. بارگذاری مشتاقانه به ORM میگوید: از همان آغاز، مشتریِ هر سفارش را هم بیاور. اغلب ابزارهای ORM سازوکاری آماده برای این کار دارند که با یک تنظیم روی خود پرسوجو فعال میشود و معمولاً در پسزمینه بهجای پیمایش جداگانه، پیوند جداول را یکجا میسازد؛ یعنی چند ده سفر، به یک سفر تبدیل میشود.
بارگذاری دستهای (Batch Loading)
وقتی داده مرتبط در چند نقطه و مرحله لازم میشود، بارگذاری دستهای گزینه میانجی خوبی است: بهجای پرسوجوهای جداگانه با شناسههای تکی، یک پرسوجو که مجموع شناسهها را گروهی میپذیرد و همه را یکجا برمیگرداند. برخی ابزارهای ORM این حالت را بهصورت خودکار پس از بارگذاری مشتاقانه یا با تنظیم دستهای اعمال میکنند و برای معماریهایی که پردازش چندمرحلهای دارند، انتخابی متعادلتر از اتصال عظیم یکجا هستند.
بازطراحی در سطح داده و سرویس
گاهی راهحل بهتری از پرسوجوها در دسترس است: اگر صفحه فهرست همیشه نام مشتری را لازم دارد، شاید ذخیره همان نام هنگام ثبت سفارش منطقی باشد؛ یعنی دادهای که نمایش پرتکرار دارد، در لحظه شکلگیری همراه رکورد نگه داشته شود. این تصمیم مبادلهای است و طرحی برای همگام ماندن با تغییر داده مرجع میخواهد؛ اما برای صفحات پرگردش، هزینه پرسوجوهای بیشمار را از ریشه حذف میکند. گزینه دیگر، ساختن نمایش آماده در لایه گزارش است که خواندنهای پرتکرار را به یک خواندن ساده تبدیل میکند.
| راهکار | چه میکند | مناسب برای | نکته احتیاط |
|---|---|---|---|
| بارگذاری مشتاقانه | داده مرتبط را همزمان با پرسوجوی ریشه میخواند | صفحههایی که همیشه به رابطه مشخصی نیاز دارند | بار بیرویه همه رابطهها میتواند پاسخ را سنگین کند |
| بارگذاری دستهای | مجموع شناسهها را گروهی میپرسد و پرسوجوهای تکراری را یکی میکند | داده مرتبطی که در چند مرحله لازم میشود | اندازه دسته باید مهار شود تا پاسخها بیسقف نشوند |
| نگهداشتن داده پرتکرار هنگام ثبت | نام یا نمایش موردنیاز را در لحظه شکلگیری رکورد ذخیره میکند | فهرستهای پرگردش با نیاز نمایشی ثابت | همگام ماندن با تغییر داده مرجع باید طراحی شود |
| پایش تعداد پرسوجو | تعداد پرسوجوی هر درخواست را میشمارد و هشدار میدهد | شناسایی زودهنگام در توسعه و عملیات | آستانه هشدار باید با واقعیت صفحات مختلف تنظیم شود |
درسآموخته
این سناریو چند درس بهجا میگذارد. نخست، آزمون با داده واقعگرایانه: اگر محیط آزمون فقط حجم کوچک ببیند، خطاهای مقیاس هرگز دیده نمیشوند. دوم، بودجه عملکردی برای صفحات پرکاربرد: حداکثر تعداد پرسوجوی قابل قبول هر درخواست را تعریف کنید و در بازبینی کد، همانطور که درستی منطق را نگاه میکنید، تعداد سفرهای داده را هم نگاه کنید. سوم، شک به حلقهها: هر جا کدی داخل حلقه به داده مرتبط دست میزند، پرسش باید این باشد که این دستزدن سفر تازه میسازد یا از مسیر آماده میآید. و چهارم، پایش مداوم: شاخص تعداد پرسوجو در هر درخواست، سادهترین ناظری است که N+1 را پیش از کاربران میبیند.
درس نهایی فراتر از این الگوست: عملکرد نتیجه یک اصلاح بزرگ نیست؛ نتیجه مجموعهای از عادتهای کوچک است که هر کدام جلوی یک الگوی گران را میگیرند، پیش از آنکه در داده واقعی ریشه بدواند.
نکات کلیدی این مقاله
- N+1 یعنی یک پرسوجوی ریشه بهعلاوه یک پرسوجو بهازای هر آیتم فهرست؛ خطر در جمع هزینههاست، نه در تکتک آنها.
- بارگذاری تنبل راحت است اما در حلقهها پرسوجوی پنهان تولید میکند؛ محل استفاده را ببینید، نه فقط پیشفرض را.
- شناسایی پیش از رفع است: گزارش پرسوجو و شمارش پرسوجوی هر درخواست، سادهترین ابزارها هستند.
- بارگذاری مشتاقانه و دستهای دو مسیر استاندارد رفعاند؛ انتخاب به الگوی مصرف داده بستگی دارد.
- محیط آزمون با داده کوچک، خطاهای مقیاس را پنهان میکند؛ داده واقعگرایانه بخشی از آزمون است.
سوالات متداول
آیا N+1 فقط مشکل ابزارهای ORM است؟
نه. ORM فقط رایجترین مولد آن است، چون بارگذاری تنبل را راحت میکند. هر کدی که در حلقه، داده مرتبط را جداگانه از پایگاه داده بخواند، حتی بدون ORM، همان الگو را میسازد. تشخیص درست، دیدن الگوست نه سرزنش ابزار.
آیا اتصال جداول همیشه بهتر از چند پرسوجوی جداگانه است؟
نه همیشه. اتصالهای چندلایه روی مجموعههای بزرگ میتوانند تعداد سطرهای حاصل را بهشکل چندبرابری منفجر کنند و خودشان گران شوند. انتخاب میان اتصال، بارگذاری دستهای و چند پرسوجوی هدفمند، به شکل رابطهها و اندازه واقعی داده بستگی دارد؛ به همین دلیل اندازهگیری بعد از هر راهکار لازم است.
چطور در بازبینی کد، N+1 را زودتر بگیریم؟
به سه نشانه دقت کنید: دستزدن به رابطه مرتبط درون حلقه، استفاده از بارگذاری تنبل در مسیر نمایش فهرستها و نبود هیچ تنظیمی برای بارگذاری مشتاقانه یا دستهای. افزودن شمارش پرسوجو در محیط توسعه هم آزمون خودکاری ساده است که همین نشانهها را به عدد قابل مذاکره تبدیل میکند.