تفاوت Incident، Problem و Change در مدیریت خدمات نرمافزاری

فرض کنید ساعت دو بامداد است و سیستم مانیتورینگ یک سامانه بانکی هشدار میدهد: درگاه پرداخت کارت به درخواستهای مشتریان پاسخ نمیدهد و تراکنشهای ناموفق بالا میروند. کارشناس نوبت شب، زنجیره پیامکهای مشتریان عصبانی را میبیند و باید در چند دقیقه تصمیم بگیرد: با این وضعیت مثل یک اختلال برخورد کند، مثل یک علت پنهان، یا مثل پیامد تغییری که هفته پیش روی سامانه اعمال شده؟
این سه راه، سه فرایند متفاوتاند: مدیریت حادثه (Incident Management)، مدیریت مشکل (Problem Management) و مدیریت تغییر (Change Management). این سه مفهوم در چارچوبهای رایج مدیریت خدمات فناوری اطلاعات مانند ITIL (Information Technology Infrastructure Library) کنار هم تعریف شدهاند و اشتباهگرفتنشان در عمل یعنی تیم اشتباهی، با اولویت اشتباهی، سراغ مسئلهای میرود. در این مقاله با همان سناریوی بامدادی پیش میرویم، سه مفهوم را تفکیک میکنیم و در پایان درسهای عملی برای سازمانتان جمع میکنیم.
سناریو در ادامه: بازگشت سرویس، شروع داستان
کارشناس شب ردیابی لاگها را شروع میکند و نشانهای از اشباع اتصالات پایگاه داده پیدا میکند. راهحل فوری شناختهشده (Workaround) اجرا میشود: راهاندازی مجدد سرویس درگاه و افزایش موقت سقف اتصالات. ساعت ۲:۴۰ درگاه به حالت عادی برمیگردد و تراکنشها جریان پیدا میکند. مشتریان خوابیدهاند، اما کار شب تازه شروع شده است.
پرسش کلیدی اینجاست: آیا مشکل حل شده؟ پاسخ صریح است: خیر. سرویس برگشته، اما چیزی که ساعت دو بامداد سرویس را به خواب برد، هنوز آنجاست و دوباره برمیگردد. تمایز میان «بازگشت سرویس» و «رفع علت»، قلب تفکیک سه مفهوم این مقاله است.
سه مفهوم، سه پرسش متفاوت
Incident؛ حادثهای که سرویس را مختل کرده است
حادثه هر رویداد ناخواستهای است که سرویس را قطع میکند یا کیفیت آن را پایین میآورد؛ از کند شدن صفحه تا از دسترس خارج شدن کامل درگاه. پرسش محوری این فرایند ساده و فوری است: «چطور سرویس را در کوتاهترین زمان به حالت عادی برگردانیم؟». معیار موفقیت هم همان است: کوتاهبودن مدت بازیابی و کمبودن تأثیر بر کاربر، حتی اگر علت اصلی هنوز کشف نشده باشد.
به همین دلیل راهحل موقت در مدیریت حادثه نهفقط اشکالی ندارد، بلکه ابزار اصلی است. گاهی سریعترین راه، برگرداندن نسخه قبلی یا خاموشکردن موقت یک قابلیت است؛ تصمیم درست همان است که کاربر را زودتر به کار برگرداند.
Problem؛ علت پنهانی که پشت حادثهها خوابیده است
مشکل، وضعیتی است که علت یک یا چند حادثه هنوز شناخته نشده یا رفع نشده است. در سناریوی ما، حادثه بامداد تمام شد اما پرسش «چرا اتصالات پایگاه داده اشباع شد؟» باقی ماند. فرایند مدیریت مشکل این پرسش را به یک پرونده رسمی تبدیل میکند: جمعآوری شواهد، تحلیل لاگها و الگوها، انجام تحلیل علت ریشهای (Root Cause Analysis) و در نهایت یا ثبت راهحل موقت پایدارتر بهعنوان خطای شناختهشده (Known Error) یا پیشنهاد یک تغییر دائمی.
نکته مهم این است که مدیریت مشکل میتواند بدون هیچ حادثهای هم شروع شود؛ تیمی که الگوی هشدارهای تکراری را میبیند و پیش از وقوع فاجعه تحقیق را شروع میکند، درست همان کار را میکند. خروجی این فرایند دانش است، نه صرفاً بستن یک تیکت.
Change؛ تغییر کنترلشدهای که وضعیت را عوض میکند
تغییر، هر دگرگونی کنترلشده در زیرساخت، کد، پیکربندی یا مستندات سرویس است. وقتی تیم مشکل ریشه را پیدا میکند — مثلاً کشف میکند یک پرسوجوی تازه که با استقرار هفته پیش وارد سامانه شده، اتصالات را نشتی میکند — راهحل دائمی معمولاً یک تغییر است: اصلاح پرسوجو، تنظیم پیکربندی یا ارتقای منابع. اما تغییر بیقید، خودش منبع حادثه است؛ به همین دلیل هر تغییر باید ارزیابی شود، تأیید شود، در زمان کمخطر اجرا شود و برنامه بازگشت داشته باشد.
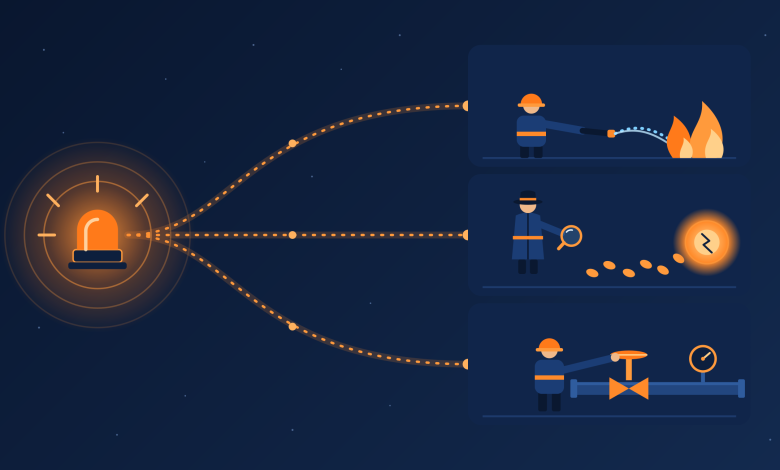
پیوند سه مفهوم در همین نقطه شکل میگیرد: حادثه زنگ خطر را به صدا درمیآورد، مشکل علت را شکار میکند و تغییر وضعیت را برای همیشه عوض میکند. اگر یکی از این حلقهها جا بیفتد، چرخه دوباره از سر گرفته میشود.
تحلیل سناریو: یک شب، سه فرایند
این سناریو نمونهای فرضی اما آشناست؛ حالا آن را با چشم فرایندی نگاه کنیم. حادثه از ساعت ۲:۰۰ تا ۲:۴۰ طول کشید و با راهحل موقت بسته شد؛ مسئولیتش با تیم عملیات و پشتیبانی بود. پرونده مشکل صبح همان روز باز شد و طی تحلیل مشخص کرد تغییر استقرار هفته پیش، علت نشتی اتصالات بوده؛ یعنی پرونده مشکل به یک تغییر قبلی رسید. تغییر اصلاحی پیشنهاد شد، در جلسه بازبینی تغییر تصویب شد، در پنجره انتشار شب جمعه اجرا شد و سنجهها طی یک هفته پایش شدند تا تأیید شود علت واقعاً رفع شده است.
یک ظرافت مهم هم هست: اگر تیم بهجای پرونده مشکل، همان شب فقط «تیکت را بسته» بود، حادثه دو هفته بعد دقیقاً با همان چهره برمیگشت؛ شاید در ساعتی بدتر و با تأثیری بیشتر. هزینه یک جلسه تحلیل و یک تغییر کنترلشده، در برابر تکرار اختلال در یک سامانه بانکی، ناچیز است.
جدول مقایسه در یک نگاه
| معیار | Incident (حادثه) | Problem (مشکل) | Change (تغییر) |
|---|---|---|---|
| پرسش اصلی | چطور سرویس را سریع برگردانیم؟ | چرا این اتفاق افتاد و چرا تکرار میشود؟ | چطور بدون شکستن چیزها تغییر کنیم؟ |
| شروع فرایند | با گزارش اختلال یا هشدار | با الگوی حادثهها یا نشانه پیشگیرانه | با نیاز به اصلاح، بهبود یا قابلیت جدید |
| خروجی کلیدی | سرویس بازگشته و راهحل موقت ثبتشده | علت ریشهای شناختهشده و راهحل پیشنهادی | وضعیت جدید تأییدشده و پایششده |
| معیار موفقیت | کوتاهبودن مدت اختلال و تأثیر بر کاربر | جلوگیری از تکرار حادثه | اجرای تغییر بدون ایجاد حادثه جدید |
| زمانبندی | فوری و در لحظه | برنامهریزیشده و تحقیقمحور | در پنجره تعیینشده و پس از تأیید |
| نقش کلیدی | تیم عملیات و پشتیبانی | تحلیلگر فنی و تیمهای تخصصی | کمیته یا مالک بازبینی تغییر |
خطاهای رایج در تفکیک سه فرایند
- مساویگرفتن بازگشت سرویس با رفع مشکل: وقتی سرویس برگشت، حادثه تمام شده است؛ بستن پرونده مشکل همزمان با آن، یعنی پذیرش تکرار حادثه در آینده.
- حادثههای تکراری بدون پرونده مشکل: اگر یک نوع اختلال بار سوم رخ میدهد و هیچ تحقیقی جاری نیست، سازمان دارد هزینه همان مشکل را روی قسطها میپردازد.
- تغییر اضطراری بدون بازبینی: فشار لحظه حادثه، اجرای تغییر بدون ارزیابی را موجه نشان میدهد؛ اما دقیقاً همین تغییرها، حادثه بعدی را میسازند. برای وضعیت اضطراری، مسیر سریعشده لازم است، نه مسیر حذفشده.
- جستوجوی مقصر بهجای علت: وقتی جلسه تحلیل حادثه به پیدا کردن «چه کسی اشتباه کرد» تبدیل شود، اعضا یاد میگیرند اطلاعات را پنهان کنند و علتهای ریشهای هرگز بیرون نمیآیند.
کاربرد عملی: از مفهوم تا فرایند در سازمان
قدم نخست عملی، جدا کردن صفهاست: در ابزار ثبت و پیگیری درخواستها (Ticketing) سه نوع پرونده با مسیر و اولویت متفاوت تعریف کنید تا «حادثه» در صف عملیات گم نشود و «مشکل» در شلوغی حادثهها فراموش نشود. قدم دوم، تعریف توافق سطح خدمات (Service Level Agreement یا SLA) برای حادثههاست: چه چیزی حادثه بحرانی است و در چه زمانی باید پاسخ داده شود؛ این تعریف باید مکتوب و برای همه روشن باشد.
قدم سوم، جلسه بازنگری پس از حادثههای مهم با رویکرد بدون سرزنش (Blameless) است: چه دیدیم، چه ندیدیم، چه چیزی بازگشت سرویس را کند کرد و کدام تغییر باید پیشنهاد شود. خروجی هر جلسه، یا یک پرونده مشکل یا یک درخواست تغییر است؛ اگر هیچکدام نبود، احتمالاً جلسه به مرور حرفها تبدیل شده است.
نکات کلیدی این مقاله
- حادثه به بازگشت سریع سرویس میاندیشد، مشکل به شکار علت ریشهای و تغییر به دگرگونی کنترلشده و پایششده سامانه.
- راهحل موقت ابزار مشروع مدیریت حادثه است؛ فقط نباید جایگزین پرونده مشکل شود.
- تغییرهای بدون ارزیابی و بازبینی از منابع اصلی حادثههای آیندهاند؛ حتی مسیر اضطراری هم باید کنترلشده باشد.
- حادثههای تکراری نشانه جاافتادن حلقه مشکلاند؛ هر تکرار هزینهای است که برای ریشه پرداخت نمیشود.
- تفکیک سه صف در ابزار تیکتینگ و جلسه بازنگری بدون سرزنش، سادهترین شروع عملی است.
سوالات متداول
یک حادثه چند بار میتواند تکرار شود تا پرونده مشکل باز شود؟
قاعده عددی جهانی وجود ندارد، اما هر سازمان میتواند آستانهای ساده تعریف کند؛ مثلاً حادثهای با علت ناشناخته که دو بار در بازه کوتاه تکرار شده، بهطور خودکار پرونده مشکل بگیرد. مهمتر از عدد، این است که کسی مسئول تشخیص الگو باشد و این مسئولیت روی کاغذ نماند.
آیا Rollback هم یک Change است؟
بله؛ بازگشت به نسخه پیشین خودش نوعی تغییر در وضعیت سرویس است، با این تفاوت که برنامهاش از قبل نوشته و تأیید شده است. به همین دلیل تیمهای باتجربه «تغییر پیشتأییدشده» تعریف میکنند: بازگشت طبق برنامه، در شرایط مشخص، بدون نیاز به جلسه نیمهشب.
در تیمهای کوچک که همهکارهاند، این تفکیک اضافهکاری نیست؟
تفکیک فرایندها با تفکیک افراد فرق دارد؛ حتی تیمی که همه چیز را یک نفر جلو میبرد، به این سه صف جدا نیاز دارد، چون نوع تصمیم متفاوت است: فوری، تحقیقی یا تأییدشده. در تیم کوچک، همین سه فهرست ساده در ابزار کار، از بزرگترین خطا جلوگیری میکند: بستن حادثه با توهم رفع مشکل.